
近日,我校语言科学与艺术学院团队的研究论文“Learning What Can Combine and What Can Substitute: Relational Inductive Biases for BabyLM Pretraining”被EMNLP 2026的BabyLM Workshop录用。研究将语言学中的组合关系与聚合关系引入语言模型预训练,探索如何让模型在有限数据条件下更有效地学习语言规律。
该研究将语言学中的组合关系与聚合关系引入语言模型训练,探索如何用有限数据学习语言规律。在1000万词语料条件下,聚合关系方法的平均综合得分由39.76提高至40.19,提升0.43分,并在三个随机种子实验中均优于对应基线。
EMNLP是自然语言处理领域的重要国际学术会议,属于CCF推荐B类会议。BabyLM Workshop是其专题研讨会,关注数据高效预训练与认知语言建模,为语言学与人工智能交叉研究提供交流平台。
本研究将语言学中的组合关系与聚合关系转化为可用于模型训练的学习目标,为有限数据条件下的语言模型预训练提供了新的方法思路。从理论上看,研究为检验语言关系组织与学习效率之间的联系提供了实验路径;从方法上看,研究展示了利用模型自身信号改进学习过程的可行性,可为数据受限的语言建模研究提供参考。论文第一作者为学院2024级硕士研究生杨于薇,第二作者为2026级硕士研究生濮世皓,酆格斐、杨亦鸣为共同通讯作者。
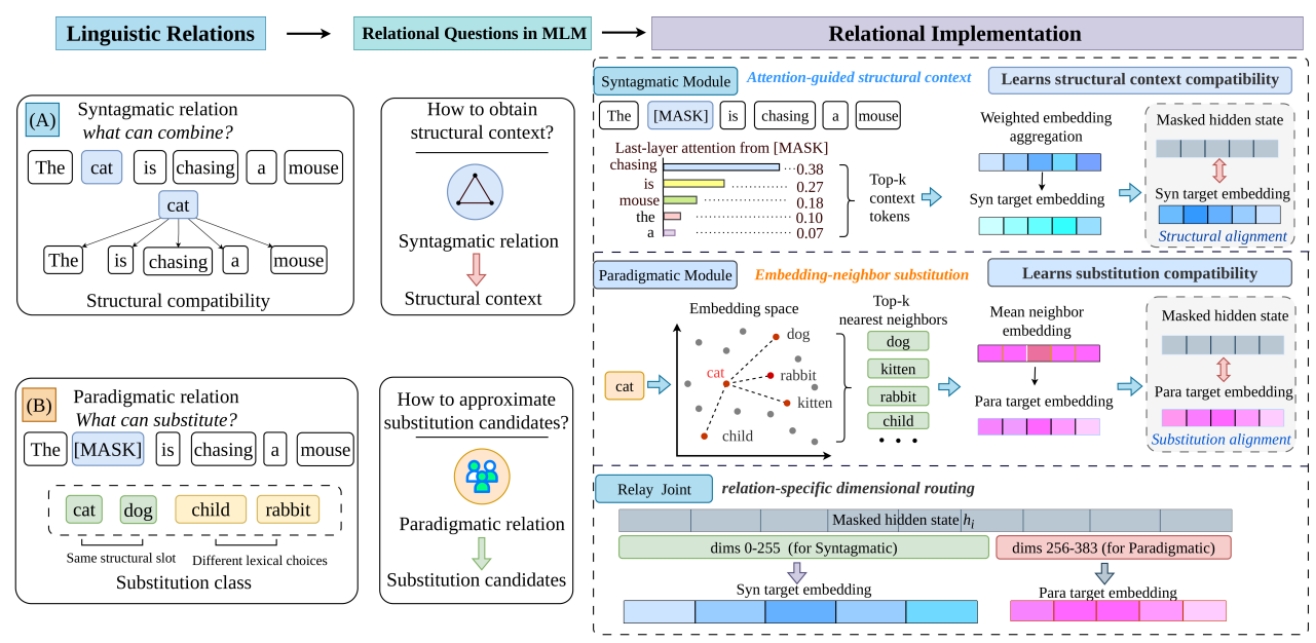
图1 论文研究框架